
Introduction aux graphes de données
Cette page a pour objectif de décrire les graphes de connaissances et les graphes de propriété, qui sont deux modèles de données utilisés dans les bases graphes.
Sommaire
Qu’est-ce qu’un graphe de données ?
Un graphe de données peut être défini comme une représentation structurée d’informations provenant de différentes sources, qui relie ces informations les unes aux autres par l’utilisation de relations. C’est un modèle de données destiné à accumuler et à transmettre des connaissances sous la forme de graphe.
Un graphe de données est constitué d’un ensemble de noeuds ou sommets reliés entre eux par des flèches orientées ou non (arcs ou arêtes). Les nœuds représentent des entités d’intérêt et les arêtes représentent les relations entre ces entités (Hogan et al, 2020). Bien que l’expression « graphe de connaissances » soit utilisée dans la littérature depuis le début des années 70, l’incarnation moderne de l’expression découle de l’annonce en 2012 du Google Knowledge Graph. Les graphes de connaissances impliquent une nouvelle confluence de techniques provenant de communautés scientifiques auparavant disparates, avec l’objectif unifié de développer de nouvelles techniques basées sur les graphes. Dans le monde du Web sémantique, on s’appuie sur le modèle RDF (Resource Description Framework) pour décrire les ressources identifiées par des URIs (Uniform Resource Identifiers).
Quand on parle de graphes de connaissances (Knowledge graph ou KG), c’est le triplet Suject-Prédicat-Objet qui est à la base de tout. Bien qu’elle soit appelée « Sujet-Prédicat-Objet » dans le RDF, la structure de triplet peut avoir d’autres noms. Nous pouvons également désigner les sujets et les objets de manière plus générique comme des entités (entity) ou des noeuds (node) reliés par une relation (relationship) ou une arête (edge) comme le montre la Figure 1.
 Figure 1 : Un triplet de base représenté par 2 sommets et une relation ( flèche orientée ou non orientée).
La théorie des graphes traite des problèmes qui possèdent une structure de graphe. Dans ce contexte, un graphe (ou un réseau, les termes étant souvent utilisés indifféremment) est constitué :
- de sommets qui sont un ensemble de points ;
- d’arêtes orientées ou non reliant ces sommets et formant des couples ordonnés ou non ; les arêtes orientées sont souvent appelées arcs.
La théorie des graphes est elle-même à la base des triplestores (bases de graphes RDF) qui sont utilisés pour stocker des informations sous forme de triplets. Dans un graphe RDF, chaque information sera représentée sous la forme d’un triplet (2 sommets et 1 arc).
D’autres modèles de graphes existent comme les graphes de propriétés (Labeled-Property Graph, LPG) dans lesquels chaque noeud et chaque relation peuvent porter un ensemble de « propriétés », des paires clé-valeur. Leur motivation première n’est pas centrée sur la sémantique, l’échange de données ou la publication, mais plutôt sur un stockage efficace qui permet une interrogation et un parcours rapides des données interconnectées. La technologie LPG ne dispose pas de schémas ou de langages de modélisation et de requêtes standardisés, ni de spécifications formelles en matière de sémantique et d’interopérabilité. De ce fait, il n’existe pas de protocoles pour intégrer les données provenant de plusieurs sources, ni d’autres mécanismes permettant d’assurer une interaction et une compatibilité transparentes entre les différentes implémentations. Ce modèle est donc particulièrement utile lorsque les données doivent être collectées à la volée et que l’analyse est effectuée dans le cadre d’un seul projet.
Du graphe de données au graphe de données sémantique
Comme défini précédemment, un « graphe de données » est un ensemble de données représentées sous forme de nœuds et d’arêtes orientées appelées arcs.
Les graphes offrent un moyen souple de conceptualiser, de représenter et d’intégrer des données diverses et incomplètes. Les graphes contiennent des descriptions qui se complètent les unes les autres, formant un réseau où chaque entité représente une partie de la description des entités qui lui sont liées ; le schéma d’un graphe est flexible, et n’a pas nécessairement besoin d’être prédéfini. Il est possible de parcourir les informations (parcours de graphe), alors que cette opération est complexe à réaliser dans le domaine relationnel.
Lorsque des données diverses sont organisées selon un modèle de connaissances (ontologies), on parle alors de « réseau sémantique » (un ensemble de graphes de données sémantiques). Les ontologies exprimées dans le langage OWL représentent la structure formelle du graphe, et constituent le schéma de données (Figure 2).
 Figure 2 : Graphe de connaissances constitué d’un schéma de graphe (ontologie) et d’un graphe de données (représentation des instances peuplant l’ontologie).
Une base de connaissances (Knowledge base ou KB) est constituée par un ensemble de graphes de connaissances (KG) stockés dans un triple store (un entrepôt de graphes de données au format RDF), interrogeables au format SPARQL. L’un des principaux cas d’utilisation des bases de connaissances est la gestion et l’interrogation des données liées composées de graphes RDF. Comme pour les bases de données relationnelles, les graphes de données RDF peuvent disposer d’un schéma et être interrogés grâce à des requêtes. Cependant, la modélisation des données est plus souple par rapport au modèle relationnel standard.
Une caractéristique importante des graphes de connaissances est leur hypothèse de monde ouvert (Open World Assumption, OWA), c’est-à-dire l’hypothèse selon laquelle la valeur de vérité d’une déclaration peut être vraie, que l’on sache ou non qu’elle est vraie. C’est le contraire de l’hypothèse d’un monde fermé (Closed World Assumption, CWA), selon laquelle toute affirmation vraie est également connue pour être vraie. En d’autres termes, l’absence d’un énoncé particulier dans un graphe de connaissances signifie, en principe, que cet énoncé n’a pas encore été formulé explicitement, qu’il soit vrai ou non, et que nous croyions ou non qu’il soit vrai, c’est-à-dire que nous ne pouvons pas déduire que l’énoncé est faux parce qu’il n’existe pas dans le graphe de connaissances.
Les graphes de connaissances fournissent ainsi un cadre efficace pour l’intégration, l’unification, l’analyse et le partage des données. Les graphes publiés sur le web peuvent se lier les uns aux autres et présenter des points de vue différents sur le même objet du monde.
Selon l’organisation ou la communauté, il peut s’agir d’un graphe de connaissances ouvert ou d’un graphe interne à une entreprise. Les graphes de connaissances ouverts sont publiés en ligne, rendant leur contenu accessible au public (DBpedia, Freebase, BabelNet, Wikidata…). Les graphes de connaissances d’entreprise sont généralement appliqués à des cas d’utilisation commerciale et leur accès est contrôlé voire limité aux membres de l’entreprise
Qu'est-ce que n'est PAS un graphe de connaissances ?
- Tous les graphes RDF ne sont pas des graphes de connaissances. Par exemple, un ensemble de données statistiques, telles que les données du PIB des pays représentées en RDF, n’est pas un graphe de connaissances. Une représentation graphe des données est souvent utile, mais il n’est pas toujours nécessaire de saisir la sémantique des données. Il peut suffire à une application d’associer la chaîne « Italie » à la chaîne « PIB » et au chiffre « 1,95 milliard » sans avoir besoin de définir ce qu’est un pays ou ce qu’est le « produit intérieur brut » d’un pays.
- Toutes les bases de connaissances ne sont pas des graphes de connaissances. Les bases de connaissances sans structure formelle ni sémantique, par exemple les bases de connaissances sous forme de questions-réponses sur un produit, ne constituent pas non plus des KG. Une caractéristique clé d’un KG est que les descriptions des entités doivent être reliées entre elles, et c’est cette liaison qui forme le graphe. Il est possible d’avoir un système expert qui dispose d’une collection de données organisées dans un format qui n’est pas un graphe, mais qui utilise des processus déductifs automatisés tels qu’un ensemble de règles « si-alors » pour faciliter l’analyse.
Pour aller plus loin : graphes à arêtes dirigées, graphes de propriétés étiquetées et ensembles de graphes nommés.
Il existe différents modèles de données basés sur les graphes. Les plus courants sont les graphes à arêtes dirigées, les graphes de propriétés étiquetées et les ensembles de graphes nommés.
Pour illustrer ce qu’est un modèle de graphe de données nous prendrons l’exemple d’un graphe de connaissances hypothétique relatif au tourisme au Chili tel que présenté par Hogan et al. [1].
Graphes orientés ou graphes à arêtes dirigées (Directed-edge labelled graph, DEL)
Un graphe orienté (« del » en abrégé en anglais) est défini comme un ensemble de sommets reliés par des arcs (des arêtes dotées d’une direction).
Comme le montre la Figure 3, les nœuds ou sommets représentent des entités (la ville de Santiago, la colline Santa Lucía, le 22 mars 2018 à midi, etc.) et les arcs ou arêtes représentent des relations binaires entre ces entités (par exemple, Santa Lucía se trouve dans la ville de Santiago).
 Figure 3 : Graphe à arêtes orientées décrivant les évènements et leurs lieux
Resource Description Framework (RDF) est un modèle de données standard basé sur les graphes del.
Par rapport au modèle relationnel standard dans lequel un schéma doit être défini à l’avance et respecté à chaque étape, cette modélisation des données offre une plus grande souplesse pour l’intégration de nouvelles sources de données. De plus, alors que d’autres modèles de données structurées tels que les arbres (XML, JSON, etc.) offrent une flexibilité similaire, les graphes ne nécessitent pas d’organiser les données de manière hiérarchique unique (à côté de la relation parent/enfant, il existe une relation frère/soeur). Les graphes del permettent également de représenter des cycles et de les interroger (par exemple, notez le cycle dirigé dans les itinéraires entre Santiago, Arica et Viña del Mar).
Graphes de propriétés étiquetées (Labeled Property Graphs, LPG)
Un graphe de propriétés est un graphe orienté qui permet d’associer aux nœuds et aux arêtes un ensemble de paires propriété-valeur (ou clé-valeur) et une étiquette. Cela offre une flexibilité supplémentaire lors de la modélisation des données, par exemple en modélisant les compagnies aériennes qui proposent des vols dans le cas de la base de connaissances sur le tourisme (Figure 4).

Figure 4 : (a) graphe à arêtes dirigées et (b) graphe de propriétés étiquetées
Comme le montre la Figure 4a, dans un graphe RDF nous ne pouvons pas annoter directement une arête comme celle de la compagnie, mais nous pourrions ajouter un nouveau nœud représentant un vol et le relier à la source, à la destination, aux compagnies et au mode, par un mécanisme appelé « réification » [2].
Inversement, la Figure 4b illustre un graphe de propriétés avec des données analogues, où les paires de valeurs de propriétés sur les arêtes modélisent les compagnies, les paires de valeurs de propriétés sur les nœuds indiquent les latitudes et les longitudes, et les étiquettes des nœuds/arêtes indiquent le type de nœud/arête. Bien qu’ils ne soient pas encore normalisés, les graphes de propriété sont utilisés dans des bases de données graphes populaires, telles que Neo4j [3]. Si le modèle offre une plus grande flexibilité quant à la manière d’encoder les données, ces graphes nécessitent également des langages d’interrogation différents (comme par exemple Cypher), et des techniques inductives plus complexes que les graphes RDF.
Ensembles de graphes nommés
Un ensemble de graphes nommé se compose d’un ensemble de graphes représenté par un nom associé à une URI, et éventuellement d’un graphe sans nom utilisable par défaut comme le montre la Figure 5.
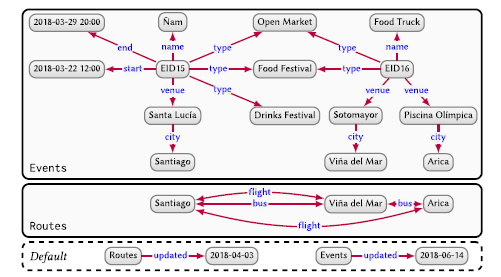
Figure 5 : Ensemble de graphes comprenant deux graphes nommés et un graphe par défaut décrivant les événements et les itinéraires
D’un point de vue technique, les ensembles de graphes sont utiles pour gérer et interroger des données provenant de sources multiples, chaque source pouvant être gérée comme un graphe distinct dans un triple store. Bien que l’exemple donné porte sur les graphes RDF, les ensembles de graphes peuvent être généralisés à d’autres types de graphes.
- Date de publication11 août 2026
- Dernière modification26 août 2026
- [1] A. Hogan, E. Blomqvist, M. Cochez, C. d’Amato, G. de Melo, C. Gutierrez, J. E. Labra Gayo, S. Kirrane, S. Neumaier, A. Polleres, R. Navigli, A. C. Ngonga Ngomo, S. M. Rashid, A. Rula, L. Schmelzeisen, J. F. Sequeda, S. Staab, and A. Zimmermann (2020). Knowledge graphs. CoRR arxiv:2003.02320
[2] D. Hernández, A. Hogan, M. Krötzsch (2015). Reifying RDF: What works well with wikidata?. 1457. 32-47. https://www.researchgate.net/publication/283865828_Reifying_RDF_What_works_well_with_wikidata
[3] J. J. Miller (2013). Graph database applications and concepts with Neo4j. In Proc. of SAIC. https://aisel.aisnet.org/cgi/viewcontent.cgi?article=1023&context=sais2013
INRAE, Introduction aux graphes et bases de connaissances, Vocabulaires Ouverts@INRAE, https://vocabulaires-ouverts.inrae.fr/
Magalie Weber
François-Xavier Sennesal, Sophie Aubin, Sonia Bravo, Anne-Sophie Bage